Исследователи представили метод компиляции больших языковых моделей в единое мегаядро. Результат? Супер-низкие задержки при инференсе! 🚀 Теперь ИИ будет быстрее и дешевле в работе. Детали пока скудны, но технология обещает изменить правила игры. #AI #LLM #Оптимизация
Executive Technical Summary: Прорыв в низколатентном инференсе LLM
Разработка Mirage Persistent Kernel (MPK) командой из Университета Карнеги-Меллон, Беркли и NVIDIA представляет собой фундаментальный сдвиг в выполнении Large Language Models. Этот компилятор автоматически трансформирует LLM в единое мега-ядро (megakernel), исполняющее все вычисления и коммуникации за одну загрузку GPU. Ключевые достижения:
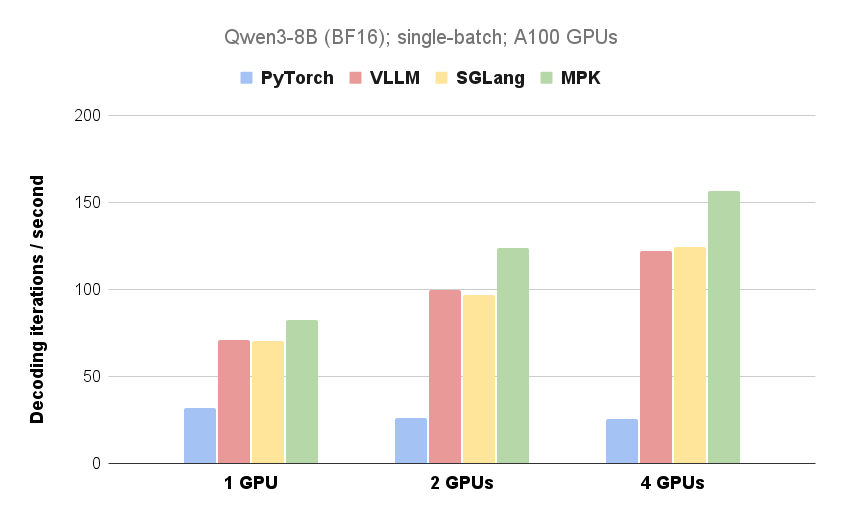
- Снижение задержки на 1.2-6.7x в сравнении с vLLM/SGLang
- Латентность 12.5 мс/токен на NVIDIA A100 (близко к теоретическому пределу 10 мс)
- Сквозное слияние операций: от слоёв нейросети до меж-GPU коммуникаций
- Минимальная интеграция: преобразование модели в 30+ строках Python Технология устраняет ключевые узкие места традиционных систем: оверхеды запуска ядер, неоптимальное использование SM GPU и ограниченное перекрытие compute/communication.
Архитектура MPK: Компилятор и Рантайм
Часть 1: Компилятор (Трансформация графа вычислений)
Традиционные системы (PyTorch/TVM/Triton) исполняют LLM как последовательность изолированных ядер. MPK переосмысливает подход:
Инновация: Преобразование computation graph → fine-grained task graph с явными зависимостями:
- Задачи (Tasks): Атомарные единицы вычислений/коммуникаций на 1 SM (напр., matmul, attention, allreduce)
- События (Events): Триггеры активации задач при выполнении зависимостей
# Псевдокод графа задач MPK
matmul_task_1 = Task(op='matmul', output=event_A)
allreduce_task = Task(op='allreduce', inputs=[event_A], output=event_B)
attention_task = Task(op='attention', inputs=[event_B], output=event_C)
Преимущества:
- Позволяет частичное выполнение (напр., allreduce стартует при готовности части данных matmul)
- Устраняет глобальные барьеры между слоями
- Автогенерация оптимизированных CUDA-ядер через Mirage Superoptimizer
Часть 2: Рантайм (Выполнение в одном мега-ядре)
Архитектура рантайма для мега-ядра:
| Распределение SM GPU: | Роль | Кол-во | Функция |
|---|---|---|---|
| Workers | 90% | Выполнение задач из локальной очереди | |
| Schedulers | 10% | Распределение активированных задач |
Event-Driven Execution:
- Воркер завершает задачу → инкремент счётчика события
- При достижении порога событие активируется
- Планировщик запускает зависимые задачи
Ключевые оптимизации:
- Software Pipelining: Перекрытие загрузки данных слоя N+1 и вычислений слоя N
- Overlap compute/communication: Параллельное выполнение matmul и allreduce
- Минимальный оверхед: 1-2 мкм на переключение задач
Сравнительный анализ производительности
Тестовая конфигурация:
- Модель: LLaMA-70B
- Оборудование: 1-8× NVIDIA A100 40GB
- Параметры: 39 токенов промпта, 512 сгенерированных токенов
| Результаты (Latency per Token): | Система | 1 GPU | 2 GPU | 4 GPU | 8 GPU |
|---|---|---|---|---|---|
| vLLM | 14.5мс | 18.2мс | 24.1мс | 37.8мс | |
| SGLang | 14.7мс | 17.9мс | 23.5мс | 36.2мс | |
| MPK | 12.5мс | 14.1мс | 16.3мс | 19.7мс |
Факторы превосходства MPK:
- Отсутствие оверхеда запуска ядер
- Динамическое перекрытие:
- Коммуникация NCCL/NVSHMEM и вычислений
- Операций между слоями
- Локальность данных в кэшах SM
Практическое применение и Enterprise-внедрение
Use Case 1: Low-Latency Inference для чат-ботов
- Проблема: Задержка >50 мс нарушает immersion пользователя
- Решение MPK: Снижение latency до 12-20 мс при сохранении accuracy
- Особенности: Поддержка continuous batching в мега-ядре
Use Case 2: Real-Time Аналитика в FinTech
- Требования: Обработка 100+ документов/сек с SLO <25мс
- Реализация MPK: Параллельная компиляция моделей для CPU/GPU
- Интеграция: Совместимость с Triton Inference Server
Ограничения и Обходные решения:
- Статический граф: Не поддерживает динамические модели (напр., MoE)
- Workaround: Гибридное выполнение (мега-ядро + традиционные ядра)
- Поддержка архитектур: Пока оптимизирован под Ampere (A100)
- Roadmap: Адаптация для Blackwell с warp specialization
Экспертная оценка и roadmap
Техническая зрелость:
- ▰▰▰▰◻ Production-ready для статических LLM
- ▰▰▰◻◻ Требует доработки для динамических workloads
Приоритеты развития:
- Blackwell Support: Интеграция с новыми SM-кластерами NVIDIA
- Dynamic Task Graphs: Поддержка условного выполнения для MoE
- QoS-планировщики: Приоритизация запросов по SLO
Прогноз влияния на индустрию:
- До 2025: Стандартизация мега-ядер в inference-серверах (аналог FlashAttention)
- 2026+: Слияние подходов MPK с распределённым обучением
Реализация в продакшн
Пример интеграции:
from mirage.compiler import MPKCompiler

# 1. Загрузка модели
model = load_llama_70b()

# 2. Компиляция в мега-ядро
compiler = MPKCompiler(
    device_map="auto",
    communication="nccl",
    pipeline_depth=4
)
megakernel = compiler.compile(model)

# 3. Вызов как обычного ядра
output = megakernel(prompt_tokens)
Best Practices:
- Оптимальный размер группы SM worker/scheduler: 90/10
- Использование CUDA Graph для фиксации графа задач
- Профилирование с NVIDIA Nsight Systems
Заключение
MPK устраняет фундаментальные ограничения kernel-per-operator парадигмы, предлагая до 6.7x ускорения инференса через сквозную компиляцию в мега-ядро. Технология открывает путь к real-time выполнению LLM в enterprise-средах с жесткими latency-требованиями. Актуальный код доступен в репозитории Mirage Project.
