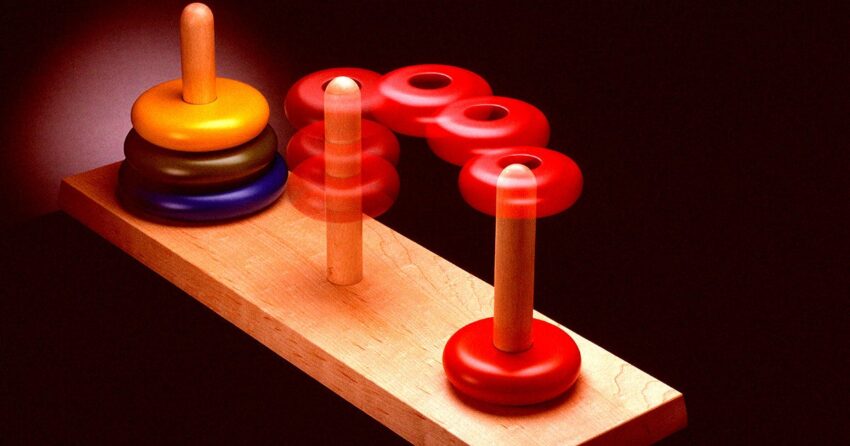
Исследователи Apple нанесли удар по хайпу! Их новое исследование показало: топовые ИИ вроде GPT-4 и Gemini на деле плохо справляются с простыми логическими задачками из детских игр. Тесты на «соображалку», которыми хвастаются разработчики, оказались необъективными 🤯.
Фокус в том, что ИИ часто запоминает шаблоны из обучающих данных, а не учится рассуждать по-настоящему. Когда ученые подсунули моделям новую головоломку (похожую на детскую «Ханойскую башню»), те споткнулись 🧩.
Вывод: заявления о «мышлении» ИИ пока преждевременны. Это ставит под вопрос реальную ценность маркетинговых обещаний. Может, нейросетям сначала в кубики поиграть? 😉
Технический релиз: Экспертный анализ исследования Apple о фундаментальных ограничениях современных LLM
Executive Technical Summary
Исследователи Apple опубликовали рецензируемую работу, демонстрирующую катастрофический провал современных Large Reasoning Models (LRM) в решении элементарных логических задач. Модели уровня GPT-4, Claude 3 и Gemini показали точность ниже 80% в головоломках Tower of Hanoi с 7 дисками и полную неспособность справиться с 8 дисками. Критически важно: модели не смогли решить задачи даже при предоставлении пошагового алгоритма, что указывает на фундаментальное отсутствие логического мышления. Это ставит под сомнение маркетинговые заявления об «интеллектуальных агентах» и открывает дискуссию о принципиальных ограничениях transformer-архитектур в задачах, требующих подлинного reasoning.
Глубокий технический анализ методологии (H2)
Экспериментальная установка и задачи
- Tower of Hanoi: Классическая задача с экспоненциальной сложностью (O(2^n)). Тестировались конфигурации с 3 стержнями и 3-8 дисками
- Blocks World: Пространственная организация объектов с ограничениями
- River Crossing: Логистическая задача с множественными constraints
Критические параметры тестирования:
- Zero-shot prompting: Задачи подавались без примеров решения
- Chain-of-Thought (CoT) анализ: Трассировка «рассуждений» моделей
- Accuracy Breakdown: Постепенное увеличение сложности до коллапса производительности
Ключевая метрика: Полный сбой точности (accuracy collapse) при переходе порога сложности (7→8 дисков в Ханое) – падение эффективности с 78% до ~0%.
Архитектурные ограничения Large Reasoning Models (H2)
Почему LRM не справляются с логикой?
-
Отсутствие истинного символьного мышления:
# Псевдокод решения Tower of Hanoi
def hanoi(n, source, target, auxiliary):
 if n > 0:
     hanoi(n-1, source, auxiliary, target)  # Ð екурсивный шаг 1
     move_disk(source, target)               # Базовый случай
     hanoi(n-1, auxiliary, target, source)  # Ð екурсивный шаг 2
LLM неспособны выполнять рекурсивные операции и строить абстрактные ментальные модели состояний
-
Проклятие распределения (Distributional Shift): Невозможность экстраполяции за пределы тренировочных данных
-
Иллюзия CoT reasoning: Генерация текста, имитирующего рассуждения ≠ действительное логическое выведение
-
Ограничения transformer-архитектуры: Отсутствие механизмов для:
- Точного отслеживания состояния (state tracking)
- Работы с длинными цепочками зависимостей
- Истинной композиционности операций
Технические последствия для enterprise-внедрения (H2)
Критические риски при промышленном использовании LLM:
- Недопустимые ошибки в системах автоматизации: Сбои в оркестрации процессов, управлении ресурсами
- Непредсказуемость в mission-critical системах: Финансовые транзакции, управление инфраструктурой
- Ложное чувство безопасности: Антропоморфизация моделей пользователями
Рекомендации Technical Leads:
- Тестировать LLM на специализированных logic benchmark suites
- Внедрять гибридные архитектуры (нейросеть + символьный ИИ)
- Для критических задач использовать детерминированные алгоритмы вместо «черного ящика» LLM
Сравнительный анализ подходов к AGI (H2)
| Параметр | Современные LLM | Классический ИИ (GOFAI) | Гибридные системы |
|---|---|---|---|
| Логическое рассуждение | Крайне ограничено | Высокое | Умеренное |
| Обобщение знаний | В рамках distribution | Низкое | Контролируемое |
| Интерпретируемость | Низкая (black box) | Высокая | Селективная |
| Enterprise-готовность | Только non-critical tasks | Проверена | Перспективная |
Экспертное заключение
Исследование Apple подтверждает фундаментальные ограничения архитектуры Transformer в задачах, требующих подлинного абстрактного мышления. Техническое сообщество должно:
- Отказаться от антропоморфных метафор в описании LLM
- Разрабатывать специализированные benchmark для оценки логических способностей
- Инвестировать в нейро-символьные гибриды и архитектуры с явным state management Перспективы AGI на текущих архитектурах остаются спекулятивными – необходим paradigm shift в дизайне моделей, а не просто масштабирование параметров.
