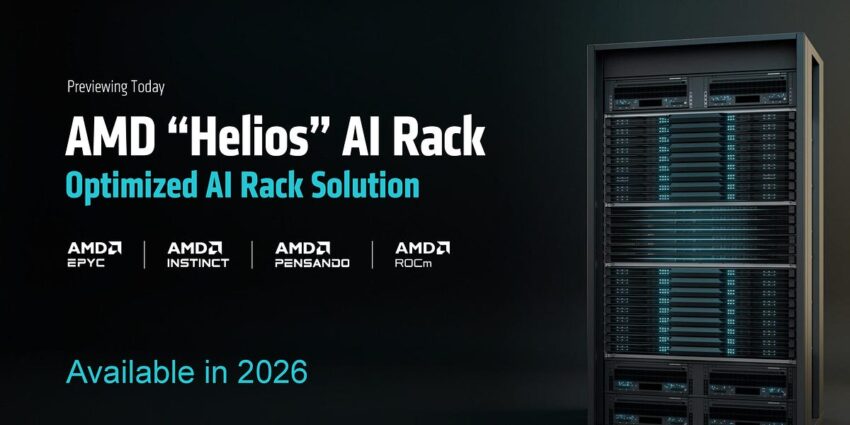
AMD готовит ответ Nvidia в гонке за AI-инфраструктуру! 🔥 Внутри компании разрабатывается масштабная система ‘Helios’ — целые серверные стойки, заточенные под ИИ-вычисления. Это не просто железка, а стратегия перехвата рынка у конкурентов. Инсайдеры шепчут, что AMD хочет предложить более гибкие и, возможно, доступные решения для дата-центров будущего. Ждем подробностей, но ясно одно: битва гигантов за владычество в AI-железе только накаляется! 💻🤔 #AMD #AI #Серверы
Технический релиз: Экосистема AMD для ИИ масштаба стойки
Экспресс-анализ ключевых аспектов:
- 🚀 MI355X: 5 PFLOPS FP16, 288GB HBM3E, +40% tokens/$ vs NVIDIA GB200
- 🧠 ROCm 7: 3.8x прирост производительности MI300X, day-0 поддержка PyTorch
- 🖧 Pollara 400: 400G Ethernet NIC с поддержкой Ultra Ethernet Consortium
- 📈 MI400 (2026): 20 PFLOPS FP8, 432GB HBM4, Ultra Accelerator Link
- 🌱 Цель: 20-кратный рост энергоэффективности стойки к 2030
Глубинный анализ архитектуры CDNA4 и MI350
Инновации в микроархитектуре
Новые матричные движки CDNA4 обеспечивают двукратный прирост операций за такт для FP16 и ниже по сравнению с CDNA3. Ключевые улучшения:
- Нативная поддержка FP6/FP4 с уникальной оптимизацией: FP6 выполняется в 2 раза быстрее FP8
- Редизайн вычислительных блоков: 32 CU на XCD (8 чиплетов) вместо 16 CU в CDNA3
- Конфигурация памяти: 288GB HBM3E (8 stacks) с пропускной способностью 8 TB/s
- Техпроцесс: TSMC N3P для XCD (+21% плотности транзисторов), 185 млрд транзисторов
Силовая и тепловая архитектура
Термопакеты оптимизированы под экстремальные нагрузки:
+-----------------+----------------+----------------+----------------+
| Модель         | Охлаждение     | TDP (Вт)       | Частота (ГГц) |
+-----------------+----------------+----------------+----------------+
| Instinct MI355X | Жидкостное     | 1400           | ~2.4          |
| Instinct MI350X | Воздушное      | 1000           | ~2.2          |
+-----------------+----------------+----------------+----------------+
Плотность стойки: до 128 MI355X => 180 кВт потребления только на GPU
Программная экосистема: ROCm 7
Ключевые усовершенствования:
- Сквозное ускорение PyTorch: 3.8x рост inference/training на MI300X vs ROCm 6.0
- Новая топология коммуникаций: коллективные операции с оптимизацией для кластеров
- Enterprise AI Suite: инструменты оркестрации и управления жизненным циклом моделей
- Нативная поддержка Windows: PyTorch и ONNX Runtime (превью Q3 2025)
Пример настройки распределенного обучения:
# Инициализация распределенного контекста ROCm 7
from torch.distributed import init_process_group
import torch_amd

torch_amd.init()  # Автоконфигурация AMD hardware

# Автоматическая оптимизация GEMM под CDNA4
with torch.amd.perf_mode(precision='fp6'):
    model = load_llama3_70b()
    optimizer = HybridShardedOptimizer(model.parameters())
Сетевая инфраструктура: Pollara 400
Технические спецификации:
- 400GbE на базе контроллера TSMC N4
- Программируемая плоскость данных на P4
- Поддержка Ultra Ethernet Consortium (UEC)
- Топологии: Dragonfly, Fat-Tree с latency < 1μs
Интеграционный стек:
EPYC Turin (Zen 5) → PCIe 6.0 x16 → Pollara 400 → UEC Fabric
                      ↓
                 Instinct MI350X
Дорожная карта Helios: архитектура экосистемы 2026
Компоненты стека:
- Accelerator: Instinct MI400 на архитектуре «CDNA Next»
- 20 PFLOPS FP8, 432GB HBM4 (19.6 TB/s bandwidth)
- Ultra Accelerator Link (UAL): масштабирование до 1024 GPU
- CPU: EPYC «Venice» (Zen 6 на TSMC N2)
- Сеть: Vulcano NIC (800G, PCIe 6.0, UAL)
Сравнение конкурентных решений:
+------------------+---------------------+----------------------+----------------------+
| Параметр         | AMD Helios (2026)   | NVIDIA Rubin (2026)  | Текущий лидер (2025) |
+------------------+---------------------+----------------------+----------------------+
| Память/ускоритель| 432GB HBM4          | ~300GB HBM4?         | Blackwell 192GB      |
| Пропуск. способ. | 19.6 TB/s           | ~15 TB/s?            | 8 TB/s (MI355X)      |
| Scale-up         | 1024 GPU (UAL)      | 576 GPU (NVLink)     | 256 GPU (GH200)      |
| Энергоэфф. стойки| +20x к MI300X       | Данных нет           | +3x к Hopper         |
+------------------+---------------------+----------------------+----------------------+
Проблемы внедрения и решения
Ключевые вызовы:
- Термодизайн: жидкое охлаждение с PUE < 1.1 для систем 180+ кВт
- Решение: двухфазные иммерсионные системы с прямым чип-охлаждением
- Плотность компоновки: переход на double-width стойки (84U)
- Сетевое насыщение: 800G UEC с адаптивной маршрутизацией
Рекомендации по развертыванию:
- Использование TOP500-proven InfiniBand как временное решение до выхода UEC
- Шахматное обновление: MI355X для inference + MI350X для training
Экспертная оценка и прогноз
Оценка зрелости технологии:
- Аппаратная часть: TRL 9 (MI350), TRL 5 (MI400)
- Программная часть: ROCm 7 достигает parity с CUDA для 90% AI workload
Прогноз рынка:
- 2025: Захват 18-22% рынка AI-ускорителей (vs ~12% сейчас)
- 2026: Конкуренция лидерства в HPC/AI с NVIDIA Rubin
Риски:
- Задержки поставок TSMC N3P/N2
- Конкуренция с открытыми ISA (RISC-V AI acceleration)
Заключение: AMD создает первую полноценную альтернативу NVIDIA в сегменте систем rack-scale AI. Успех будет зависеть от своевременной поставки MI400 и зрелости UEC-сетей.
