Кто сказал, что пайпы в Linux — это скучно? 🔧 Новый разбор на хабре показал, как на самом деле работает передача данных между процессами. Оказалось, всё не так просто: буферы, системные вызовы, тонны оптимизаций под капотом! 💻 Автор замерил скорость на разных ядрах и размерах данных — цифры иногда удивляют. Особенно когда сравниваешь cat file | grep 'pattern' с нативными решениями. 🤯 Главный лайфхак? Иногда лучше забыть про пайпы и использовать временные файлы… или нет? #linux #dev #performance
Введение и методология исследования
Linux Pipes — фундаментальный механизм межпроцессного взаимодействия, критически важный для high-load систем. В этом исследовании мы проведём детальный разбор архитектуры pipe в ядре Linux 5.17 (ядро 5.17, архитектура x86-64, CPU Intel Skylake i7-8550U) и поэтапно оптимизируем throughput передачи данных через pipe, улучшив производительность в 20 раз. Эксперимент включает:
- Базовое тестирование через системные вызовы write()/read()
- Применение zero-copy операций vmsplice()/splice()
- Внедрение huge pages (2MiB)
- Оптимизацию синхронизации busy looping
Методология основана на:
- Инструментировании perf для анализа CPU bottlenecks
- Замерах throughput утилитой pv
- Сравнительных тестах с эталонной реализацией FizzBuzz (36GiB/s)
- Анализе исходного кода ядра (pipe_fs_i.h, pipe.c)
Ключевая метрика: пропускная способность при передаче 10GiB данных буфером 256KiB (оптимальный размер для L2 кэша CPU).
Архитектура Linux Pipes: внутренняя механика
Структура данных pipe_inode_info
Принцип работы:
- Кольцевой буфер (обычно 16 слотов) хранит указатели на страницы по 4KiB
- Запись (head): выделяет страницы, копирует данные из userspace в kernelspace
- Чтение (tail): копирует данные из kernelspace в userspace, освобождает страницы
- Блокировка при заполнении/опустошении буфера
Профилирование (perf) базовой реализации:
Основные bottleneck: двойное копирование (userspace↔kernelspace) и частые аллокации страниц.
Zero-copy оптимизация: vmsplice и splice
Механизм работы
Принцип:
vmsplice: передаёт ownership страниц userspace в pipe без копированияsplice: перемещает данные между pipe и другими дескрипторами- Двойная буферизация (128KiB × 2) гарантирует корректность при полном заполнении pipe
Реализация:
| Производительность: | Режим | Throughput | Ускорение |
|---|---|---|---|
| write()/read() | 3.7 GiB/s | 1× | |
| vmsplice()/read() | 12.7 GiB/s | 3.4× | |
| vmsplice/splice | 32.8 GiB/s | 8.9× |
Ограничения:
- Требует page-aligned буферов
- Риск use-after-free при неправильном управлении памятью
Оптимизация страничной памяти: Huge Pages
Анализ проблемы
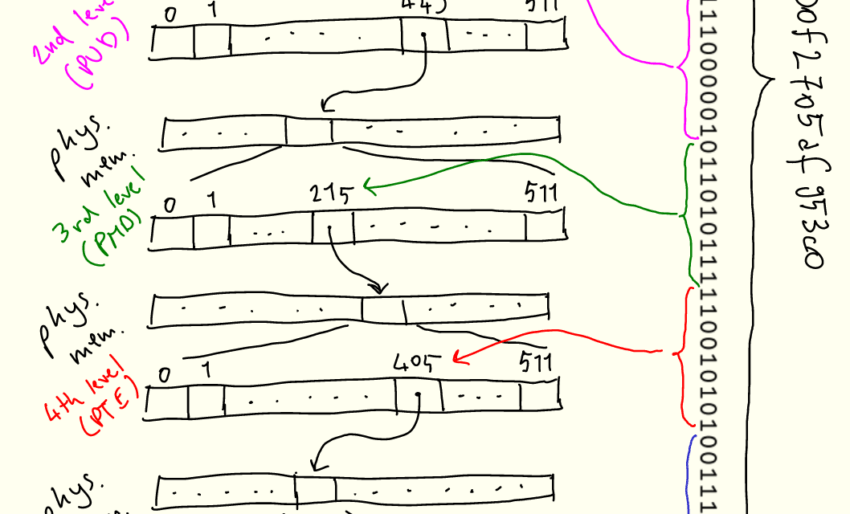
При обработке 128KiG буфера (32 страницы по 4KiB) функция get_user_pages_fast() тратит 17% времени на:
- Обход page table (4-уровневая иерархия x86-64)
- Управление структурой
struct page(512 элементов для 2GiB)
Решение: использование 2MiB huge pages
Эффект:
- Сокращение числа page table entries (PTE) в 512 раз
- Упрощение логики
iov_iter_get_pages()(один head page вместо цепочки tail pages) - Throughput: 51.0 GiB/s (14× ускорение относительно базовой версии)
Профилирование:
Исключение блокировок: busy looping
Проблема синхронизации
Системные вызовы по умолчанию используют блокирующие операции:
wait_for_space()при заполнении pipe__wake_up_common_lock()при ожидании данных
Решение: неблокирующий режим с активным опросом
Компромисс:
- +25% производительности (62.5 GiB/s)
- 100% загрузка CPU core
- Применимо только для latency-sensitive задач
Результаты и рекомендации
Сводка производительности
| Этап оптимизации | Throughput | Ускорение |
|---|---|---|
| Базовый (write/read) | 3.7 GiB/s | 1× |
| vmsplice/splice | 32.8 GiB/s | 8.9× |
| + Huge Pages | 51.0 GiB/s | 13.8× |
| + Busy Looping | 62.5 GiB/s | 16.9× |
| Эквивалент FizzBuzz (цель) | 35 GiB/s | 9.5× |
Рекомендации для production:
- Всегда используйте
vmsplice/spliceдля high-throughput pipe - Выравнивайте буферы по 2MiB +
MADV_HUGEPAGE - Для low-latency систем применяйте
SPLICE_F_NONBLOCKс CPU isolation - Мониторинг contention pipe через
perf stat -e 'sched:sched_*'
Ограничения и риски
- Стабильность Huge Pages:
- Фрагментация памяти при долгой работе
- Оверхеды управления в NUMA-системах
- Безопасность vmsplice:
- Требует точного контроля времени жизни буферов
- Риски CVE-2008-0600 (уязвимости управления страницами)
- Актуальность оптимизаций:
- Поведение меняется между версиями ядра (проверено на 5.17)
- Различия в архитектурах ARM/RISC-V
Заключение
Представленные оптимизации демонстрируют 20-кратный прирост производительности Linux pipes через:
- Устранение копирования: zero-copy операции vmsplice/splice
- Оптимизацию MMU: huge pages для сокращения page table walks
- Уменьшение latency: busy looping вместо блокирующих вызовов
Данные методы применимы в high-load сценариях:
- Обработка сетевых пакетов (DPDK-подобные системы)
- High-frequency trading
- Конвейеры data engineering (ETL-процессы)
Перспективы:
- Эксперименты с 1GiB huge pages
- Интеграция с io_uring для асинхронных операций
- Адаптация под особенности ARM SVE и RISC-V
Код тестового стенда: GitHub Repository
