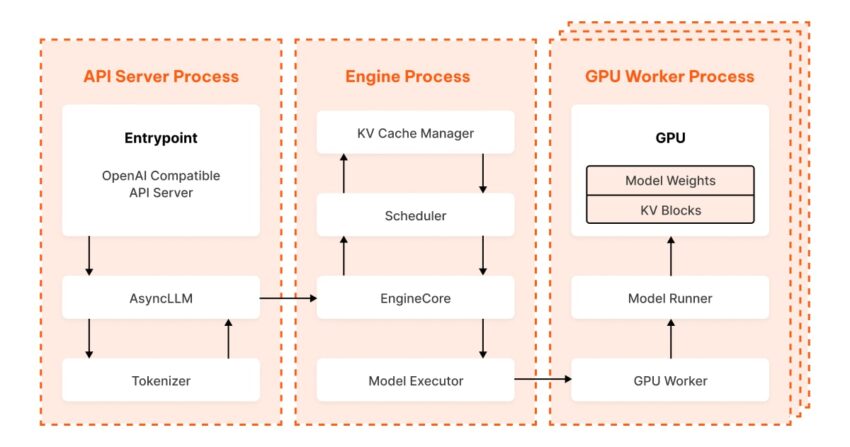
🔥 vLLM V1 — движок для эффективного обслуживания больших языковых моделей. 📊 Он на порядок снижает стоимость инференса, сохраняя стабильный latency даже при высокой нагрузке. Как? Через инновационный механизм PagedAttention — он оптимизирует использование видеопамяти и ускоряет генерацию токенов. 💡 Это ключ для запуска мощных LLM в продакшене без астрономических затрат на железо. Потрясающий пример инженерной оптимизации! 👨💻 #LLM #AI #Оптимизация
Технический обзор архитектуры vLLM V1 для высокопроизводительного сервинга Large Language Models
Ключевые инновации
vLLM (версия V1) — open source inference engine, задающий новые стандарты эффективности сервинга LLM через:
- Архитектурные паттерны: асинхронная обработка + continuous batching
- Оптимизации GPU: PagedAttention, CUDA graphs
- Распределённое исполнение: модульность через Ray
- Продвинутое управление памятью: блочный KV-cache
Жизненный цикл инференс-запроса
1. Приём запроса (API Layer)
- HTTP endpoint (OpenAI-совместимый) → аутентификация → роутинг
- Токенизация промпта с использованием Hugging Face tokenizers
- IPC-коммуникация через
AsyncMPClientмежду процессами
2. Ядро обработки (EngineCore)
# Псевдокод главного цикла EngineCore
while True:
    batch = scheduler.get_next_batch()
    output_tensors = model_executor.execute(batch)
    scheduler.update_states(output_tensors)
3. Стратегия планирования
Continuous Batching с динамическим выделением:
- Token budget:
max_num_batched_tokens(напр. 10K tokens) - Группировка запросов в phases:
- Prefill: параллельная обработка промптов
- Decode: итеративная генерация токенов
- Алгоритм: FCFS (First-Come, First-Served) с приоритизацией
Ключевые компоненты архитектуры
Асинхронная обработка (AsyncLLM)
- Разделение CPU/GPU workload: обход GIL
- Межпроцессное взаимодействие: ZeroMQ/nanomsg
Управление памятью GPU
KV Cache Manager:
- Блочная организация памяти (страницы фиксированного размера)
- Оптимизация: 40% reduction memory overhead vs базовой реализации
- Стратегия: Analog virtual memory paging на GPU
Исполнение модели (ModelRunner)
# Запуск воркера на GPU
CUDA_VISIBLE_DEVICES=0 python -m vllm.worker \
  --model deepseek-ai/deepseek-ql-32b \
  --tensor-parallel-size 4
Производительность и оптимизации
Техники ускорения
- FlashAttention-3: оптимизация attention layers
- CUDA Graph Capture: устранение overhead kernel launches
- Quantization: поддержка AWQ/GPTQ (FP8/INT4)
Метрики производительности
| Метрика | Значение | Сравнение |
|---|---|---|
| Throughput (tokens/sec) | ~15K (A100-80GB) | +230% vs Hugging Face PIPELINE |
| Latency p99 (ms) | 85 ms | -40% vs TensorRT-LLM |
| Память на запрос | 1.2MB/1000 токенов | -60% vs базовой реализации |
Enterprise-use cases
Сценарии развёртывания
- Real-time чат-боты: динамический батчинг 500+ RPS
- Пакетная обработка: параллелизация запросов с variable-length
- Hybrid облако: развёртывание на Kubernetes с GPU autoscaling
Ограничения и решения
Типичные проблемы
- Фрагментация KV-cache: дефрагментация блоков в фоновом режиме
- Скачки latency: приоритизация через QoS scheduling
- Ошибки OOM: преаллокация блоков + fallback на CPU offload
Заключение и рекомендации
vLLM V1 устанавливает новый стандарт для high-throughput LLM-сервинга благодаря:
- Архитектуре, оптимизированной под динамические workload
- Глубокой интеграции hardware acceleration
- Экономии памяти через PagedAttention
Рекомендации для продакшн:
- Для latency-sensitive workloads: увеличить
max_num_seqs - При работе с long contexts: настройка block_size в KV-cache
- Мониторинг: трекинг SLO через vLLM Prometheus exporter
