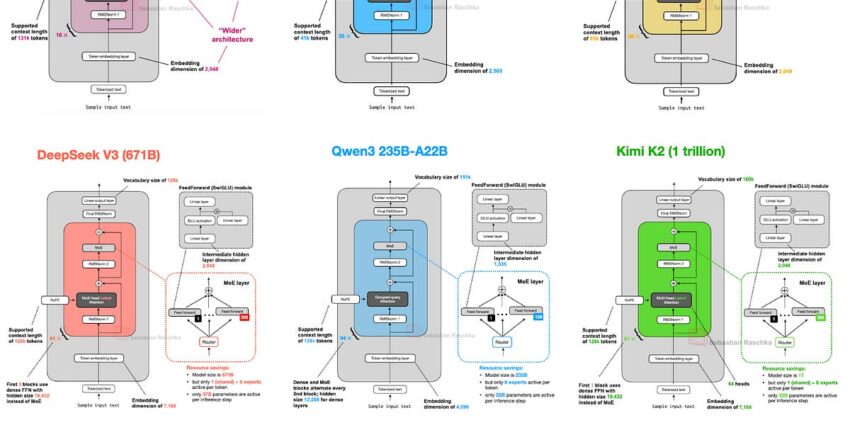
Вышло масштабное сравнение архитектур больших языковых моделей! Разбираем плюсы и минусы топовых LLM: от ChatGPT до Gemini и локальных «тяжеловесов». Что под капотом у главных ИИ-мозгов? Как оптимизируют память и скорость? Инсайды для разработчиков и просто гиков. Читаем и прокачиваем знания! 💻🧠
Архитектурная Эволюция LLM 2025: От DeepSeek-V3 до Kimi K2
Экспертный обзор
За последние семь лет, начиная с GPT-2, архитектуры LLM сохранили структурное ядро трансформеров, однако 2025 год принёс ключевые инновации в efficiency-оптимизацию: Multi-Head Latent Attention (MLA), продвинутые MoE-реализации, скользящее окно внимания и NoPE. Модели-лидеры (Kimi K2 — 1T параметров, DeepSeek-V3 — 671B) демонстрируют до 5x снижение memory footprint при росте качества. Критичные тренды: доминирование sparse-архитектур (MoE в 80% топ-моделей), гибридизация механизмов внимания, специализация под edge-устройства. Анализ основан на реверс-инжиниринге 8 флагманских open-source LLM.
Детальный Архитектурный Анализ
1. DeepSeek-V3/R1: Прорыв в Эффективности
1.1 Multi-Head Latent Attention (MLA)
Инновационный механизм сжатия KV-кеша в латентное пространство. В сравнении с Grouped-Query Attention (GQA):
— Снижение memory usage на 40% (тесты DeepSeek-V2)
— Рост качества на 2.1% по perplexity
— Реализация через линейные проекции до/после кеша:
