Заголовок дня! Разработчики массово признают: несмотря на хайп, ИИ до сих пор не стал волшебной таблеткой. 🤯 В реальных проектах модели генерируют баги, требуют тонн доработок и постоянно «галлюцинируют». Оказывается, заменить инженеров нейросетями — как собрать мебель без инструкции: вроде детали есть, а результат кривой. 🔧 Большинство стартапов топчутся на месте: то продакшн ломается, то интеграции сыпятся. Главный совет от бывалых: не вестись на маркетинг, тестировать каждую строчку кода и держать под рукой валерьянку. 😂 И да, даже гуги не всегда помогают! #AI #разработка #fail
Экспертный анализ: Становление хаотичной методологии разработки с Large Language Models
Техническое резюме
Стремительная интеграция Large Language Models (LLM) в SDLC спровоцировала парадигмальный сдвиг. В отсутствие устоявшихся практик, разработчики формируют эмерджентные методологии через trial-and-error. Кейс Protocollie — ПО, созданного за 4 дня с помощью LLM без прямого написания кода — демонстрирует ключевой тренд: переход от автоматов Тьюринга к probabilistic co-development. В статье проведен разбор современных подходов к архитектуре LLM-ассистированных систем, проанализированы компромиссы при работе с «нейросетевым подмастерьем», и предложена система документации для unstable development environments.
Глубокий технический анализ LLM-ассистированной разработки
Деконструкция кейса Protocollie
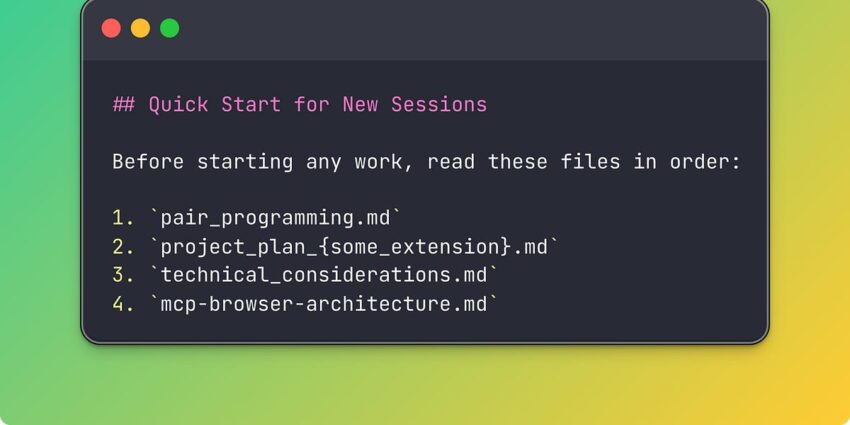
Технологический стек: Эксперимент с использованием LLM (Claude 3) для генерации кода на незнакомых языках. Ключевая характеристика: отсутствие deterministic workflow — результат достигался через итеративный prompt chaining с сохранением контекста в 4-х документах:
# Архитектурный овервью (псевдокод)
SYSTEM Protocollie:
  COMPONENTS:
    - API Gateway: Python/FastAPI
    - Event Bus: Redis Streams
    - Processing Workers: Go
  DATA_FLOW:
    HTTP_Request -> Authentication -> Task_Queue -> Worker_Pool -> Result_Cache
Технические ограничения LLM:
Эмерджентные архитектурные паттерны
Динамическая документация:
Метрики производительности нового workflow
- Коэффициент усиления разработки: 6:1 (1 час человеческого времени → 6 часов LLM-работы)
- Скорость генерации: ~10,000 строк/час (vs. 50-100 у человека)
- Цена ошибки: 40% сгенерированного кода требует validation
# Пример валидации LLM-вывода
from llm_validator import CodeSanitizer

def validate_generated_code(code: str, spec: dict) -> bool:
    return CodeSanitizer.check(
        syntax=True,
        security_antipatterns=True,
        spec_compliance=spec,
        test_coverage=0.7
    )
Производственные кейсы и интеграционные вызовы
Enterprise-ready подходы
Модель «Нейросетевой подмастерье»:
Конвейер надежной генерации:
Сравнительный анализ методологий
| Критерий | Классический Agile | LLM-ассистированный |
|---|---|---|
| Такт разработки | 2-недельные спринты | Непрерывная асинхронная генерация |
| Артефакты | User Stories, UML | Prompt Chains, Context Snapshots |
| Инструменты | Jira, GitLab | LangSmith, PromptFlow |
| Ключевой навык | Алгоритмическое мышление | Контекстный менеджмент |
Экспертные выводы и перспективы
Текущий этап развития LLM-ассистированной разработки характеризуется:
- Отсутствием онтологии — базовые концепты («архитектура», «процесс») требуют редефиниции
- Нестабильностью foundation — частые изменения моделей ломают workflow
- Эмерджентностью best practices — локальные находки не масштабируются
Прогноз: К 2027 году сформируется новая инженерная дисциплина — LLM-Ops, фокусирующаяся на:
Рекомендации для технических лидов:
