Cerebras побила рекорды, разогнав Llama 4 Maverick до 2,500 триллионов операций в секунду. Это новый уровень для ИИ-моделей с 400 млрд параметров. Готовьтесь к сверхбыстрому машинному обучению! 🔥
Лид: Технический прорыв в инференсе LLM
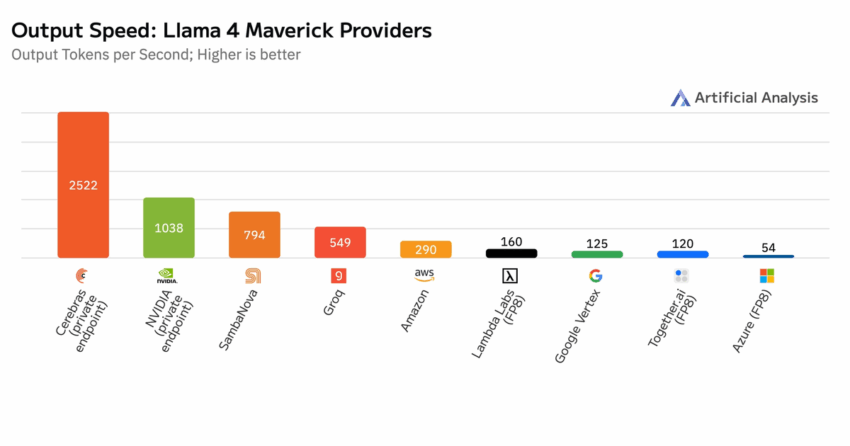
Cerebras Systems совершила технологический прорыв, достигнув скорости обработки 2 522 токенов в секунду на модели Llama 4 Maverick с 400 миллиардами параметров. Этот результат более чем вдвое превышает показатели флагманского решения NVIDIA Blackwell (1 038 TPS) и значительно опережает другие платформы: SambaNova (794 TPS), Groq (549 TPS), Amazon (290 TPS), Google (125 TPS) и Microsoft Azure (54 TPS).
Архитектурные особенности и тестовые условия
Ключевые технические различия платформ
Согласно данным независимой аналитической компании Artificial Analysis, Cerebras достигла рекорда без специальных оптимизаций ядра, в то время как NVIDIA использовала кастомные программные настройки, недоступные большинству пользователей. Важно отметить, что:
- NVIDIA работала с batch size 1-2, что снижает утилизацию GPU до <1%
- Cerebras поддерживает высокую пропускную способность без снижения эффективности
- Решение Cerebras уже доступно для коммерческого использования
Технические ограничения конкурентов
Как отметил CEO Cerebras Эндрю Фельдман, современные ИИ-приложения (агенты, генерация кода, сложные рассуждения) часто сталкиваются с проблемами задержек инференса. На GPU скорость генерации может падать до 100 TPS, что делает промышленное внедрение непрактичным.
Практическое значение для индустрии
Критические сценарии использования
Рекордные показатели Cerebras особенно важны для:
- Агентных workflow с цепочками рассуждений
- Систем сложного планирования и извлечения информации
- Приложений реального времени (голосовые интерфейсы, аналитика)
Доступность технологии
В отличие от тестового стенда NVIDIA, аппаратное обеспечение и API Cerebras:
- Уже доступны для коммерческого развертывания
- Будут интегрированы в сервис Meta API в ближайшее время
- Не требуют эксклюзивных оптимизаций для достижения максимальной производительности
Технические выводы и перспективы
Cerebras не только установила новый отраслевой стандарт производительности инференса LLM, но и продемонстрировала преимущества своей архитектуры для промышленного внедрения. Это достижение может значительно ускорить внедрение сложных ИИ-приложений в enterprise-секторе, где ключевыми факторами являются низкая задержка и высокая пропускная способность.
